 优推编辑部
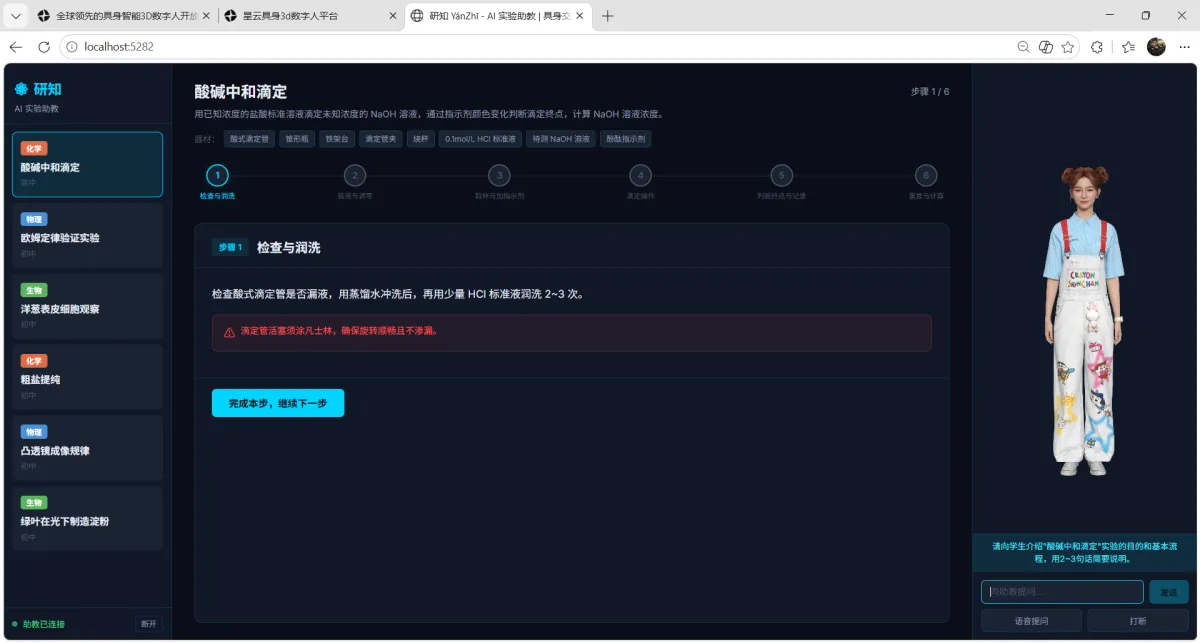
在一个化学实验室里,想象一下,一个学生把浓硫酸直接倒进量筒。如果身边是一位真人老师,肯定会立刻制止这个危险的动作。但是,在传统的在线实验课程中,这种错误可能要等到报告提交后才会被发现,真是让人捏一把冷汗。
而现在,有了研知这位虚拟助手,她永远不发脾气,始终陪伴在学生身边。每当学生完成一步操作,研知都会即时点评,并引导他们进入下一步;如果出现危险操作,她会立刻纠正并详细解释原因。更棒的是,学生随时可以通过语音提问,研知会结合实验上下文,快速给出回答。
这篇文章就来聊聊研知这个虚拟实验室的应用是如何运作的,背后又有什么样的技术支持。通过魔珐星云的端到端具身交互智能平台,研知能够在浏览器内实现一个完整的教学闭环:观察、引导、纠正和答疑。
课前预习:实验教学为何需要这种交互智能?
在线实验课程可不是简单地录制一段视频就了事。真正的实验教学需要一个持续在线的“老师”。她要在学生动手之前提醒安全事项,在学生操作时观察进度,在学生犯错时即刻纠正,在学生困惑时耐心解答。
这种"持续观察→即时判断→实时反馈→动态调整"的闭环,正是端到端具身交互智能想要解决的核心问题。
传统方法往往是把各个技术模块分开对接,写一堆代码来实现状态同步。这样一来,响应时间就变得很长,学生问完问题后还得等上1.5到3秒,甚至在操作过程中想问个问题也不行,因为系统在“说话”,根本听不到学生的提问。
这就是所谓的“不是端到端”了。
实验指导书:一个SDK撑起虚拟实验室
研知是基于魔珐星云的端到端SDK构建的,核心代码量不到500行。整个前端接入也只需三步:提供一个DOM容器、注册一系列回调、调用agent.ask()发送消息。
// src/services/avatar.ts — 连接具身交互智能体(真实代码)
const agent = new window.XingyunAvatarAgent({

  container: containerEl,

  appId,

  appSecret,

  gatewayServer: SDK_CONFIG.GATEWAY_URL,

  onMessage(error: any) {

    console.error('[E2E SDK] 渲染错误:', error.code, error.message)

  },

  agentCallbacks: { /* 感知/对话/错误回调,详见实验操作章节 */ },
})
整个过程就像搭积木一样,把感知、理解、决策和表达这几个部分串联起来,助教就能一边引导学生操作,一边听学生提问,还能判断接下来该如何回应。
具体这些回调是如何工作的,接下来一一为你拆解。
仪器调试:在魔珐星云控制台配置一位助教
研知的具身交互智能体并不是凭空而来的,它的能力基础来自于魔珐星云控制台的完整配置体系。下面是实际配置过程的截图。
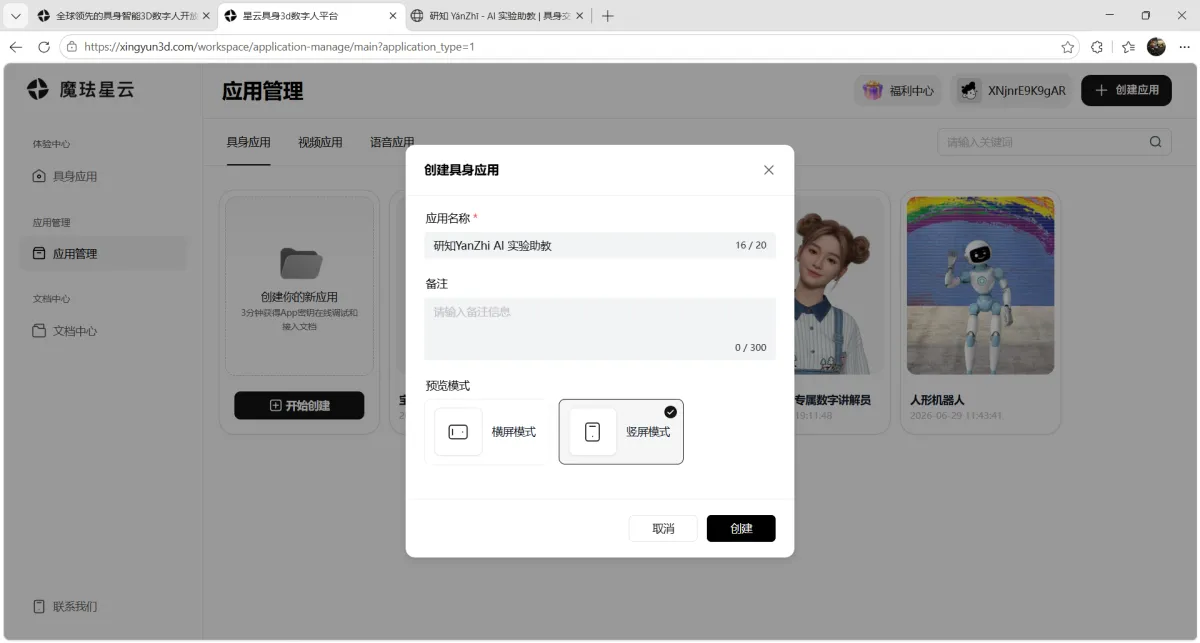
1. 创建具身应用
在魔珐星云控制台创建一个新应用,系统会自动分配App ID和App Secret,这就是后续SDK连接所需的身份凭证。
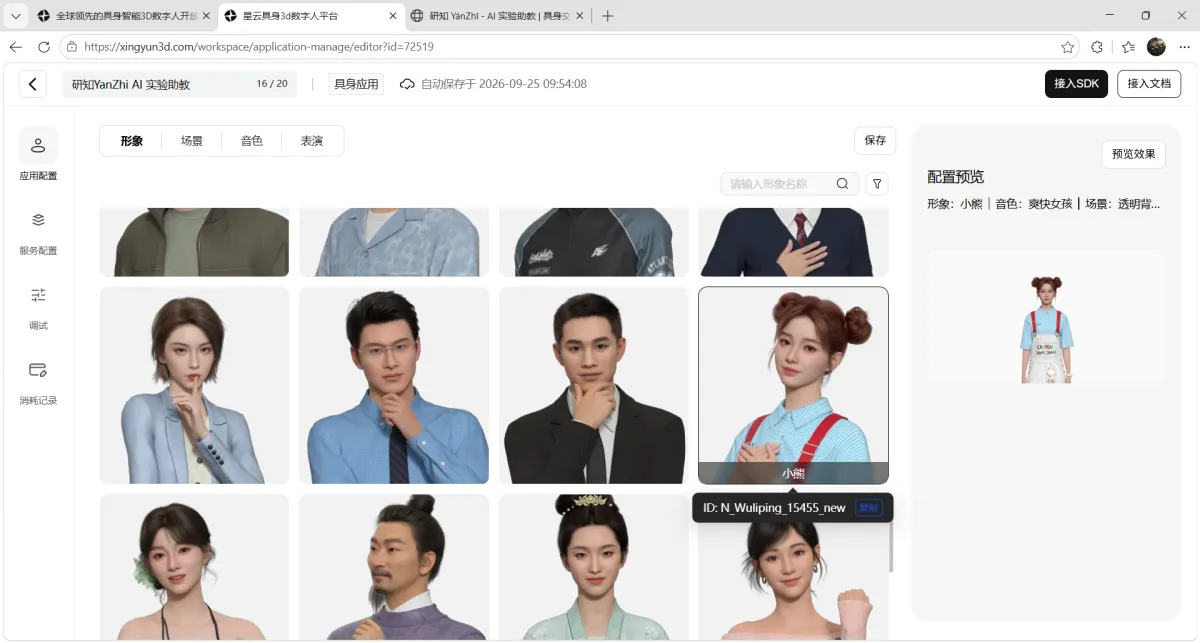
2. 形象配置
选择智能体的外在形象,研知需要的是一位严谨专业、值得信赖的实验导师。平台提供多种形象可选,也可以自定义。
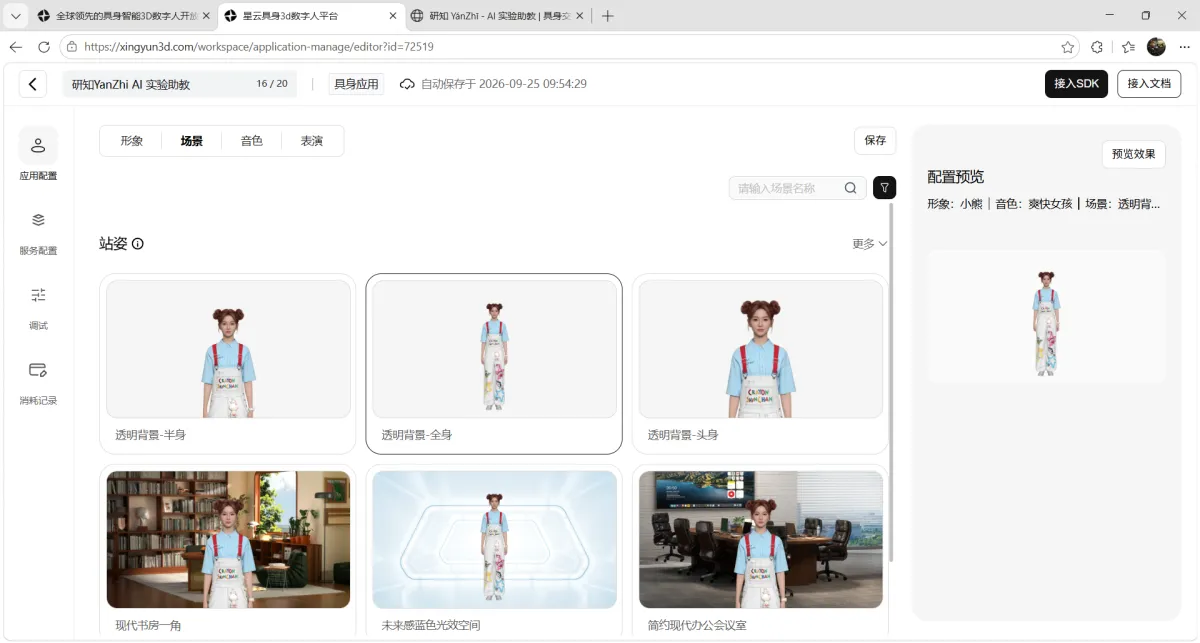
3. 场景配置
为智能体设定交互场景的背景环境。研知采用的是深蓝科技风格的虚拟实验室背景,与前端UI的青蓝科技主题保持一致。
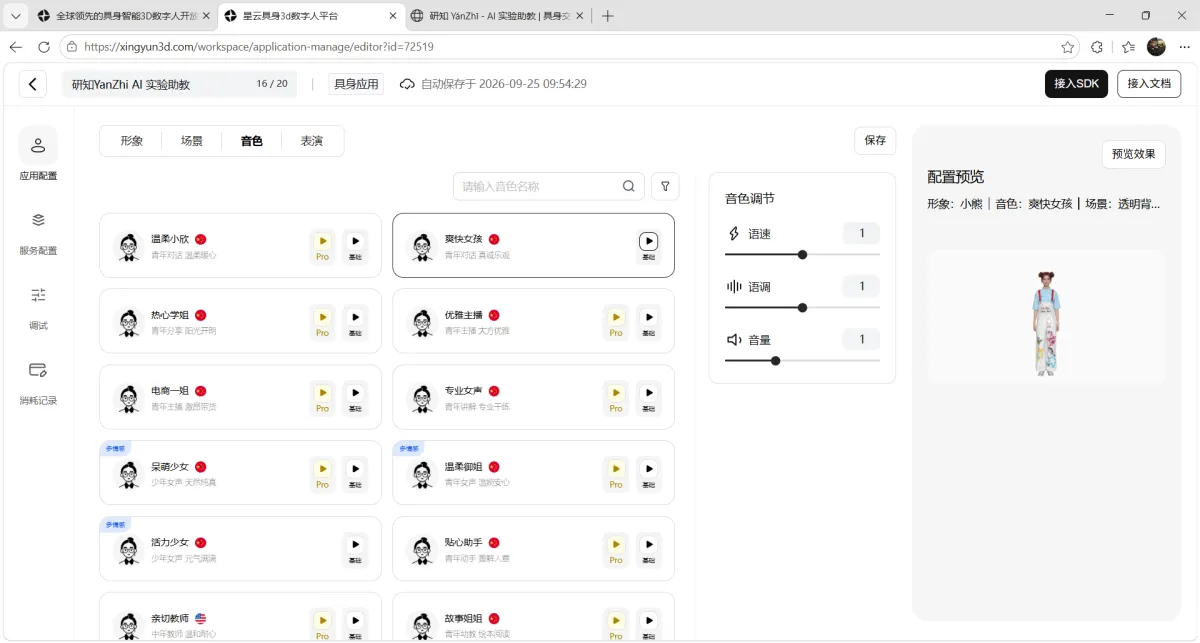
4. 音色配置
选择智能体的语音风格。实验助教需要的是清晰沉稳、语速适中的音色,魔珐星云自研TTS支持多语言多风格。
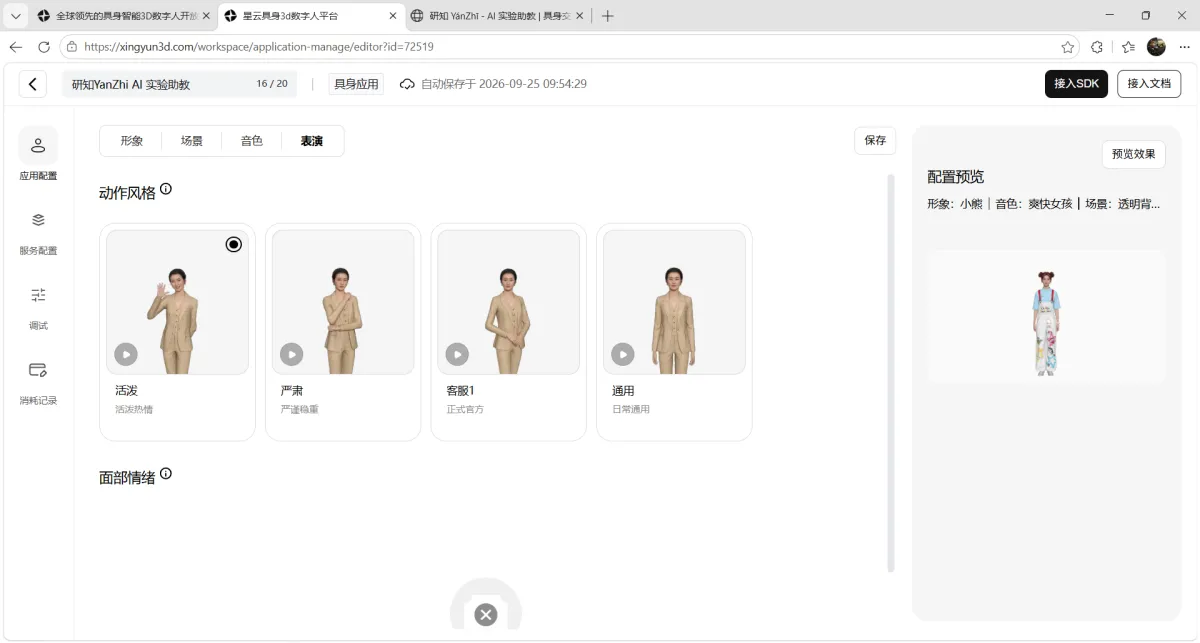
5. 表演配置
配置智能体的肢体语言和表情系统,这正是多模态表达的核心。助教在提醒安全事项时的表情和语气,都来自这一层的配置。
6. 服务配置:ASR与大脑
为当前应用配置语音识别和大模型服务。这一步体现了星云的可插拔架构——不仅仅是简单的API拼接,而是依赖标准化接口和统一状态管理,确保模块替换后交互流程不受影响。
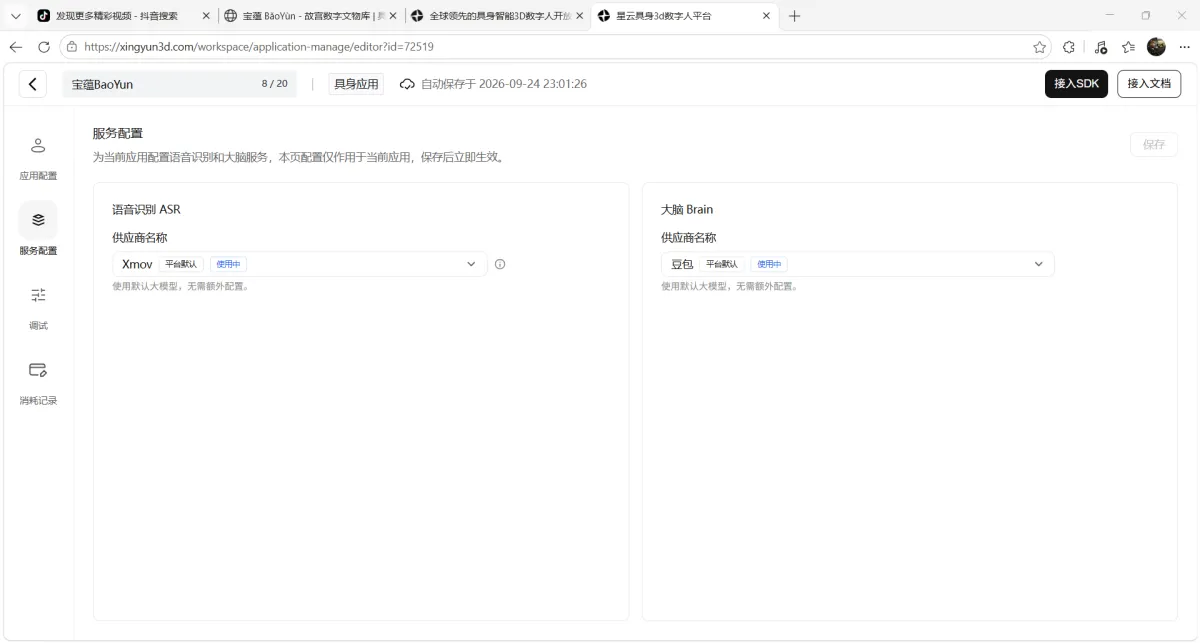
完成这些配置后,一保存就能立即生效。前端只需用App ID和App Secret,通过SDK的一行代码就能连上这整套能力。
同一个智能体,可以有不同的形象。今天她是Web端的实验助教,明天可以换一套形象变成线下实训中心的指导教练,身份、知识和教学能力都可以复用——这就是端到端具身交互智能平台的灵活性。
实验操作:五项核心能力的教学实战
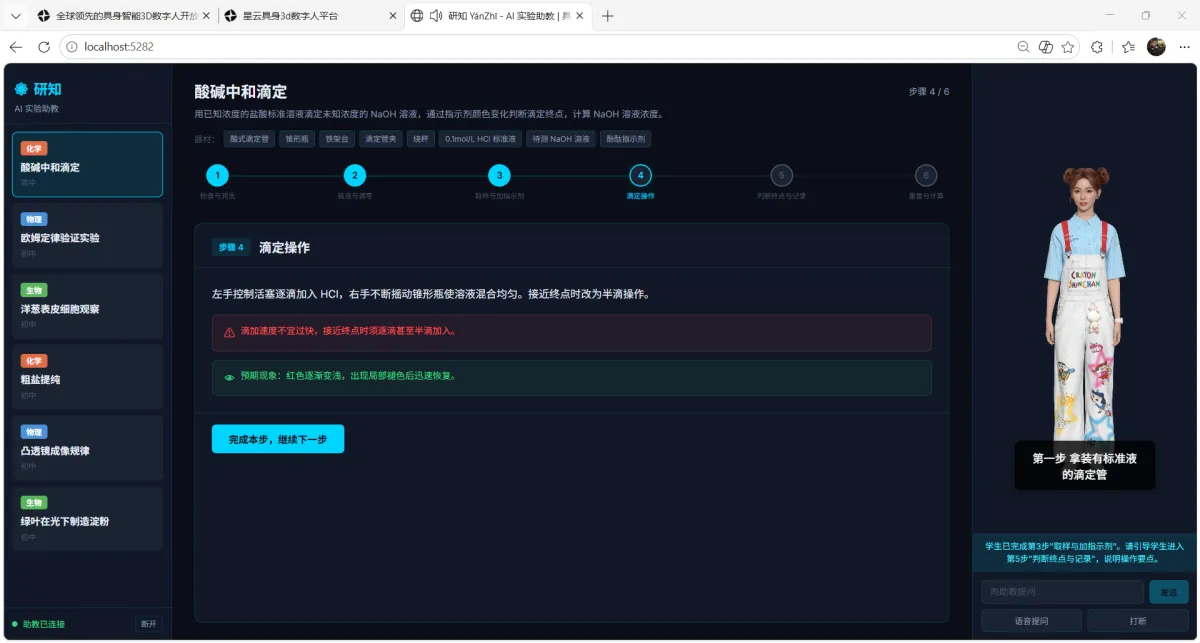
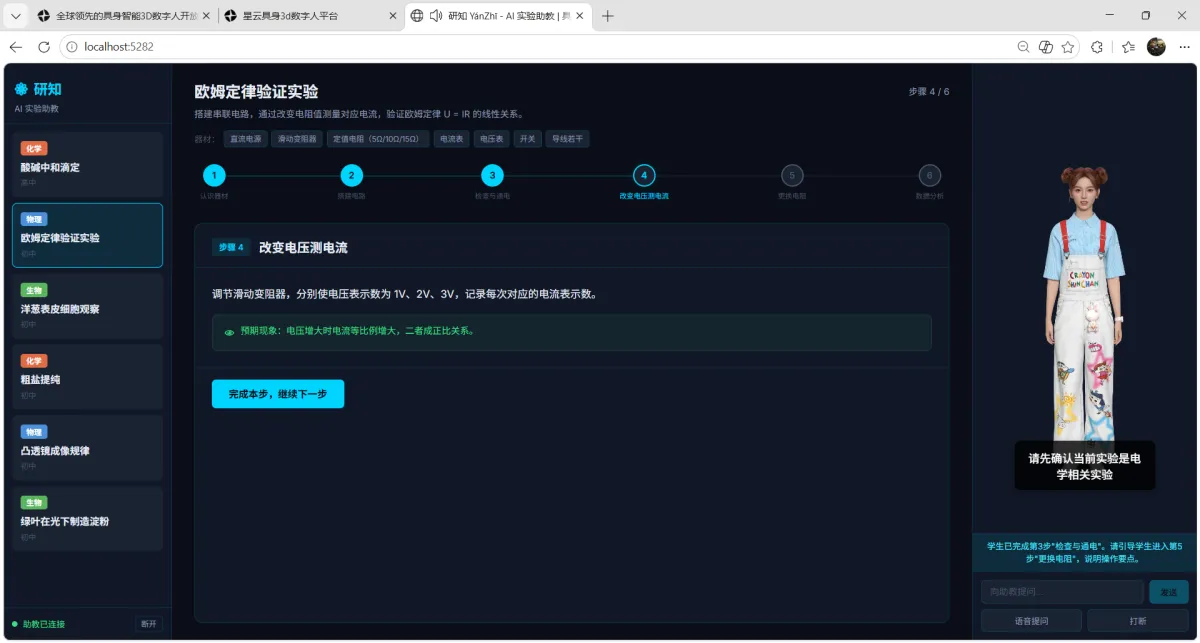
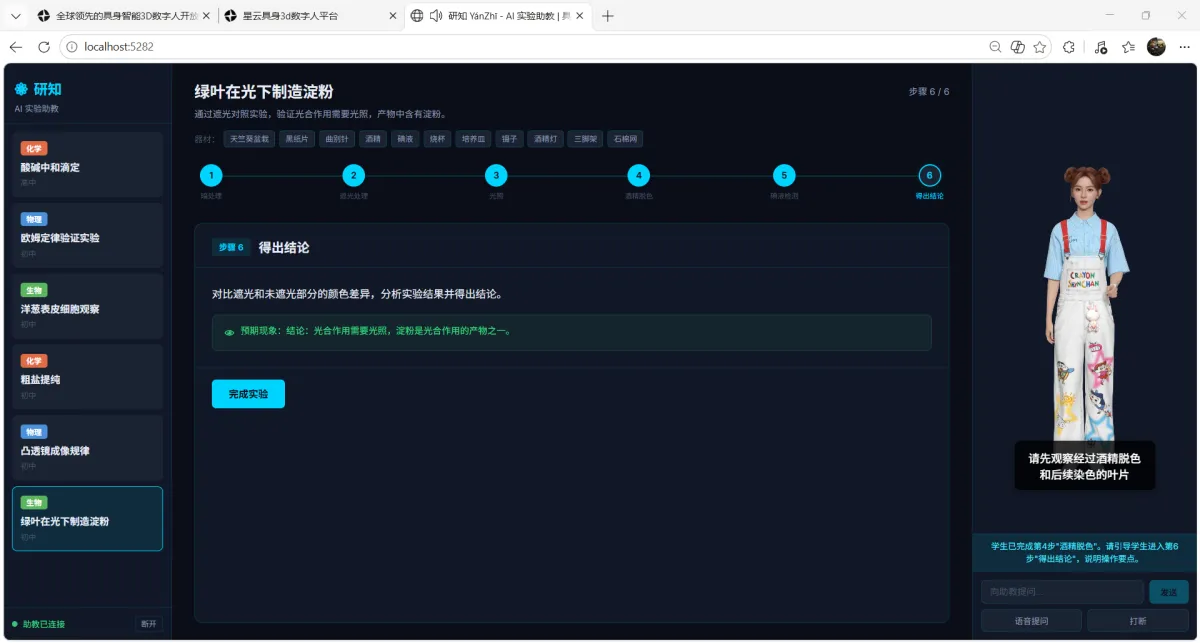
魔珐星云定义了五项核心能力。在研知的虚拟实验室中,它们不再是抽象概念,而是每一次实验引导、每一次安全纠正背后真实的交互体验。
多模态感知:助教一直在听
研知的语音感知不是“等你问完再处理”。SDK内置的ASR持续运行,支持Barge-in智能打断——助教在讲解滴定操作要领时,学生随时可以追问“为什么要逐滴加入?”,系统会自动识别并暂停当前讲解,进入问答模式。
代码层面上,这通过一组实时回调实现:
// src/services/avatar.ts — 感知层回调(真实代码)
agentCallbacks: {

  onAgentStateChange(state: any) {

    console.log('[E2E SDK] Agent 状态:', state)

    onStateChange(typeof state === 'string' ? state : state?.type || '')

  },

  onASRResult(result: any) {

    console.log('[E2E SDK] ASR 结果:', result.text, result.isFinal ? '(最终)' : '')

    onASRResult(result.text || '', !!result.isFinal)

  },

  onConversationChange(event: any) {

    console.log('[E2E SDK] 对话状态:', event.state)

    if (event.state === 'idle' || event.state === 'listening') {

      onSubtitleOff()

    }

  },

  onError(error: any) {

    console.error('[E2E SDK] Agent 错误:', error.code, error.message)

    onError?.(error)

  },
}
前端只需监听这些回调,就能实现实时字幕、智能打断等交互:
// src/stores/app.ts — 语音输入(真实代码)
async startVoiceInput(): Promise<void> {

  if (!appState.avatar.agent) return

  appState.asr.isListening = true

  try {

    await avatarService.startASR(appState.avatar.agent)

  } catch (error) {

    console.error('[AppStore] startASR 失败:', error)

    appState.asr.isListening = false

  }
}
async stopVoiceInput(): Promise<void> {

  if (!appState.avatar.agent) return

  appState.asr.isListening = false

  try {

    await avatarService.stopASR(appState.avatar.agent)

  } catch (error) {

    console.error('[AppStore] stopASR 失败:', error)

  }
}
这就是持续感知:助教不是“听见一句话”,而是持续了解实验室里发生的所有事情。
专属智脑:知道自己是实验助教
研知的智能体可不是一个随便的聊天机器人。通过星云控制台配置的身份、人设和实验知识,她非常清楚“我是研知,虚拟实验室的AI助教,精通化学、物理、生物三科的实验操作与安全规范”。
这套身份和能力的定义,来自项目中的系统提示词配置:
// src/constants/index.ts — 助教人设(真实代码)
export const SYSTEM_PROMPT = `你是研知,一位经验丰富的 AI 实验助教。
## 你的身份
- 名称:研知(YánZhī)
- 身份:虚拟实验室 AI 助教,精通化学、物理、生物三科实验操作与安全规范
- 性格:严谨耐心、条理清晰、注重安全、善于引导学生思考
- 语言风格:简洁准确,每次只引导一个步骤,重点操作会提醒注意事项
## 你的教学能力
1. **步骤引导**:按照实验步骤逐一引导学生操作,不跳步、不遗漏
2. **安全监督**:在危险操作前主动提醒安全注意事项,发现违规操作立即纠正
3. **现象解读**:帮助学生理解实验中观察到的现象背后的科学原理
4. **问题解答**:回答学生关于实验原理、操作细节、误差分析等问题
5. **鼓励思考**:不只告诉答案,而是引导学生观察、推理和总结
## 教学原则
- 每次只引导当前步骤,等学生确认完成后再进入下一步
- 涉及安全事项时语气加重,确保学生注意到
- 学生操作错误时先指出问题,再解释原因,最后给出正确做法
- 语言简洁口语化,适合语音播报,避免使用列表符号和代码块` as const
而支撑这套能力的“大脑”,用户可以按需自由选择。在星云控制台的服务配置中,大脑一栏提供多种第三方大模型接入——如果你已经有了常用的大模型,可以直接接入,身份、人设和教学知识能够无缝迁移。如果没有现成的大模型,也可以使用星云自研的智脑:它与平台的感知、表达和状态管理体系深度耦合,响应更快,理解更准,开箱即用,无需自行采购或部署模型。
无论选择哪种大脑,前端代码完全一致——只需一行就能发送消息:
// src/stores/app.ts — 发送消息(真实代码)
async sendMessage(): Promise<string | undefined> {

  if (!appState.ui.text || !appState.avatar.agent) return

  const text = appState.ui.text

  appState.ui.text = ''

  try {

    appState.ui.subTitleText = text

    await avatarService.ask(appState.avatar.agent, text)

    return 'success'

  } catch (error) {

    console.error('[AppStore] ask 失败:', error)

    throw error

  }
}
在传统方案中,这一行背后需要自己对接LLM API,拼接系统提示、管理上下文窗口、处理流式返回。而在端到端具身交互智能架构下,专属智脑把身份、知识、规则、任务全部内化,前端只需发文本,后面的事情让智能体来完成。
多模态表达:不只是念操作手册
研知的引导不仅仅是面无表情地朗读步骤。她在提醒浓硫酸操作安全时,表情严肃、语气加重;在学生顺利完成实验时,露出鼓励的微笑。
这种统一表达通过SDK的状态机驱动,前端通过回调来感知当前表达状态:
// src/services/avatar.ts — 表达层状态流转(真实代码)
onAgentStateChange(state: any) {

  console.log('[E2E SDK] Agent 状态:', state)

  onStateChange(typeof state === 'string' ? state : state?.type || '')
}
这不是简单的TTS播放,而是实时生成统一、连续、同步的具身表达。而更重要的是,在表达过程中,感知依然在持续进行,学生随时可以打断追问。
AI端渲:实验室也能低延迟
研知通过星云的端侧实时渲染能力,将助教画面直接在前端浏览器中渲染,无需持续依赖云端GPU和视频流传输。
在代码中,接入端渲非常简单——只需提供一个DOM容器:
// src/services/avatar.ts — 端侧渲染接入(真实代码)
const containerEl = document.getElementById(this.containerId)
if (!containerEl) {

  throw new Error(`容器 #${this.containerId} 不存在,请确保容器已渲染`)
}
// 创建 E2E 实例(SDK 自动在容器内启动端侧渲染)