 优推编辑部
在2026年9月,一个名为Jev的AI工具在开发者圈子里引起了轰动。与传统的聊天或创作型AI不同,Jev的功能十分单一,它只专注于提供判断。由TypeSafe AI推出的Jev被称为“系统一模型”。接下来,我将深入探讨LLM和Jev的不同之处,从它们的原理、发展到应用场景和面试准备,一一剖析。
一、痛点场景:你是否也遇到过类似问题?
让我先给大家讲几个现实中发生的场景,看看你是否也曾为此烦恼。
痛点1:客服系统的高昂开销
某电商公司的客服系统,每一条用户消息都需要交给GPT-4进行意图分类。每天10万条工单,分类一次需消耗800个token,每月的API费用超过12万。更糟糕的是,这种简单的判断却往往需要冗长的解释,格式错乱的情况更是频繁,导致5%以上的解析失败率。
痛点2:Agent的成本问题
在一家创业公司,AI Agent每执行一步都要向LLM询问:“下一步该做什么?”一个用户的任务平均需要调用15次LLM,单次任务花费约3元,团队根本无法大规模应用。虽然他们希望简单的判断能交给小模型,但小模型的理解能力不足,常常出错。
痛点3:内容审核的GPU压力
某内容平台需要审核每天500万条UGC。用大模型审核,延迟高达2秒,成本令人咋舌;用传统BERT分类器,无法处理需要语义推理的判断。“这条投诉是不是真的”这种问题就难倒了他们。
痛点4:面试时的难题
在2026年下半年,越来越多的AI公司面试开始询问:“你知道Jev是什么吗?”如果你仍然只会说“就是个分类模型”,那就落后了。
这些痛点实际上指向同一个问题:我们总是用“会说话的模型”来完成“只需做判断”的工作,结果是浪费又慢。
二、LLM与Jev到底是什么?
2.1 概念解析
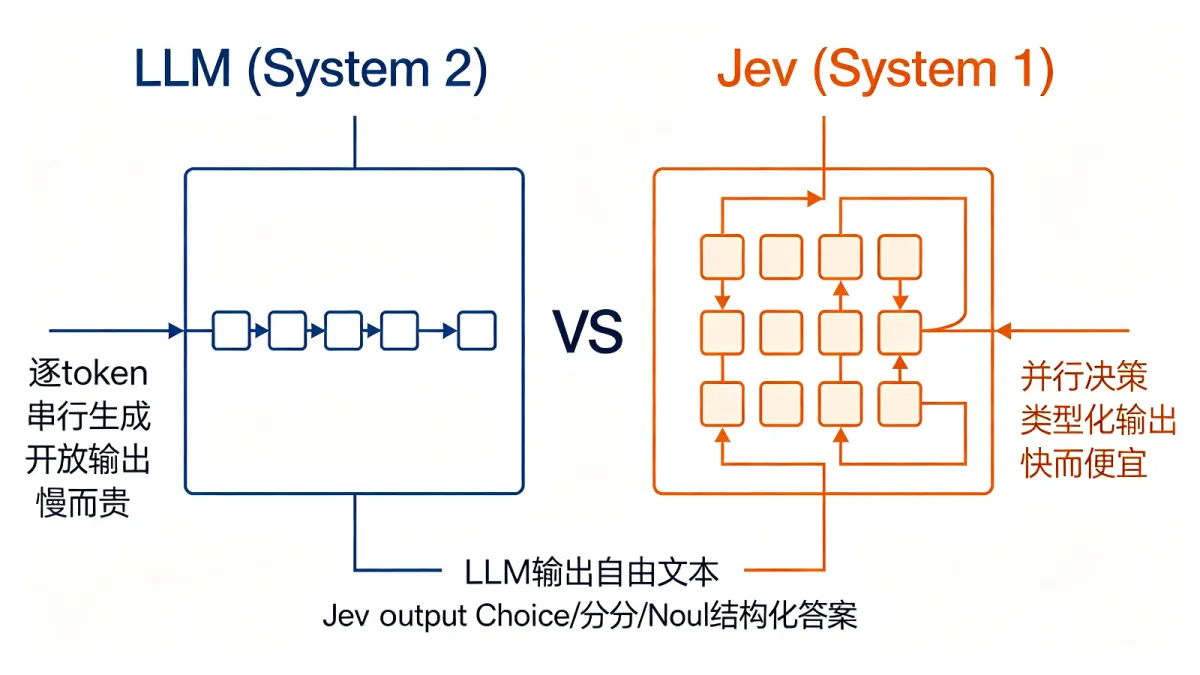
LLM(大语言模型):基于Transformer Decoder架构,通过自回归的方式逐个生成文本的通用模型。像GPT、Claude等,它们擅长理解、生成和推理,是当前AI应用的主力。
Jev:由TypeSafe AI于2026年9月推出的“系统一模型”。它不生成自由文本,而是接受一段状态和一组结构化问题,直接返回带概率的类型化答案。它的口号是“做决策,而不是输出文本”。
2.2 Jev的核心功能
Jev的操作相当简单,主要有三种:
| 功能 | 全称 | 作用 | 返回值 |
|---|---|---|---|
| Choice | 选择 | 从候选选项中选一个 | 选项和概率分布 |
| Score | 评分 | 根据标准打分 | 分数和置信区间 |
| Noul | 二元判断 | 是/否问题 | 0到1之间的概率 |
2.3 形象比喻
打个比方:
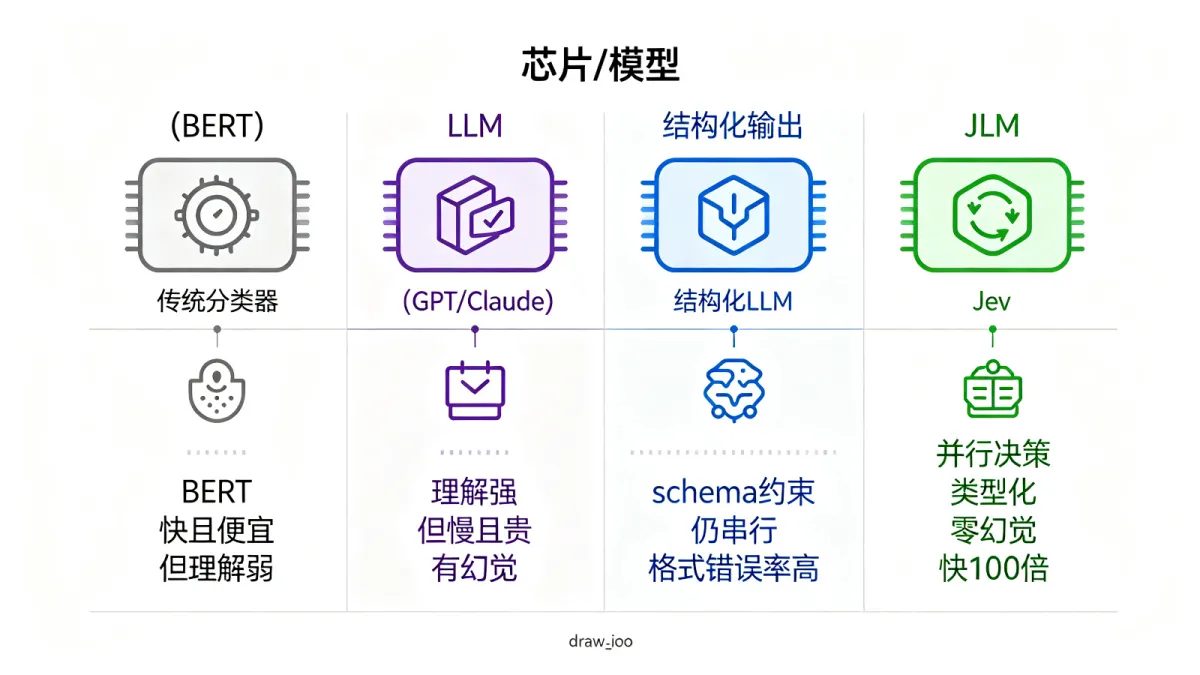
LLM像个博学的教授。问它任何问题,它都会写一篇小论文。优点是啥都能说,缺点是慢、成本高,还可能瞎扯。
Jev像个快速的裁判。你问:“这个球出界了吗?”他一秒钟就能断定:“出界,95%概率。”没有废话,只有判断。
2.4 生活中的例子
再举个简单的例子,你去餐厅,服务员问:“要辣吗?”
用LLM:它会给你写一段建议,内容冗长,可能说:“鉴于您上次点了微辣,今天天气热,我建议您选择微辣……”说了300字,你只想知道“要”还是“不要”。
用Jev:它直接回答:“要辣,概率0.85。”你就根据这个决定要不要。
在这里,LLM是那位写点评的美食家,而Jev则是那位能迅速判断“这菜能不能吃”的质检员。
三、为什么选择Jev?LLM真的足够吗?
3.1 LLM决策中的问题
第一,生成速度慢。
LLM是自回归模型,一个个token生成。你问个是/否的问题,它得先思考“嗯……”,再说“这个问题……”,最后才会回答“是”。生成50个token才能给你答案,延迟和成本都浪费在这些无用的文字上。
而Jev采用并行采样,可以同时处理多个问题,一次性给出结果。TypeSafe官方数据显示,它的处理速度比同类LLM快20-200倍。
第二,自由输出容易出错。
让LLM输出JSON格式,它可能还多说一句“好的,这是结果”;你要求1到5的评分,它可能说“我觉得大概是3分左右”,这样的结果很难稳定解析。某些模型的格式错误率甚至高达45.5%。
而Jev的输出格式在请求时已明确规定,返回的就是直接可用的数据,格式错误率为0。
第三,成本太高。
单次分类任务,LLM消耗上百个token,费用大约是0.03到0.18美元;而Jev的输入token定价为42美元/十亿,输出token永久免费,单次任务成本大约为0.0004美元,差别可谓天壤之别。
3.2 为什么不直接用BERT小分类器?
有人可能会问:“用BERT分类不是更快更便宜吗?”
问题在于:
BERT需要为每个任务进行微调。客服意图分类和内容审核都得单独训练,维护成本高。
BERT的理解能力有限。它无法理解“这个投诉里客户说‘算了’,其实是非常生气”的上下文推理。
BERT没有概率校准。它给出的分数,你无法知道这个0.8究竟有多大的把握。
Jev则通过校准决策的强化学习训练,确保其输出的概率是经过验证的——它说90%,长期来看确实准确。因此,在工程系统中,依据这个概率设定阈值就变得重要了。
3.3 解决方案:快速与慢的分工
Jev的设计理念源自卡尼曼的《思考,快与慢》:
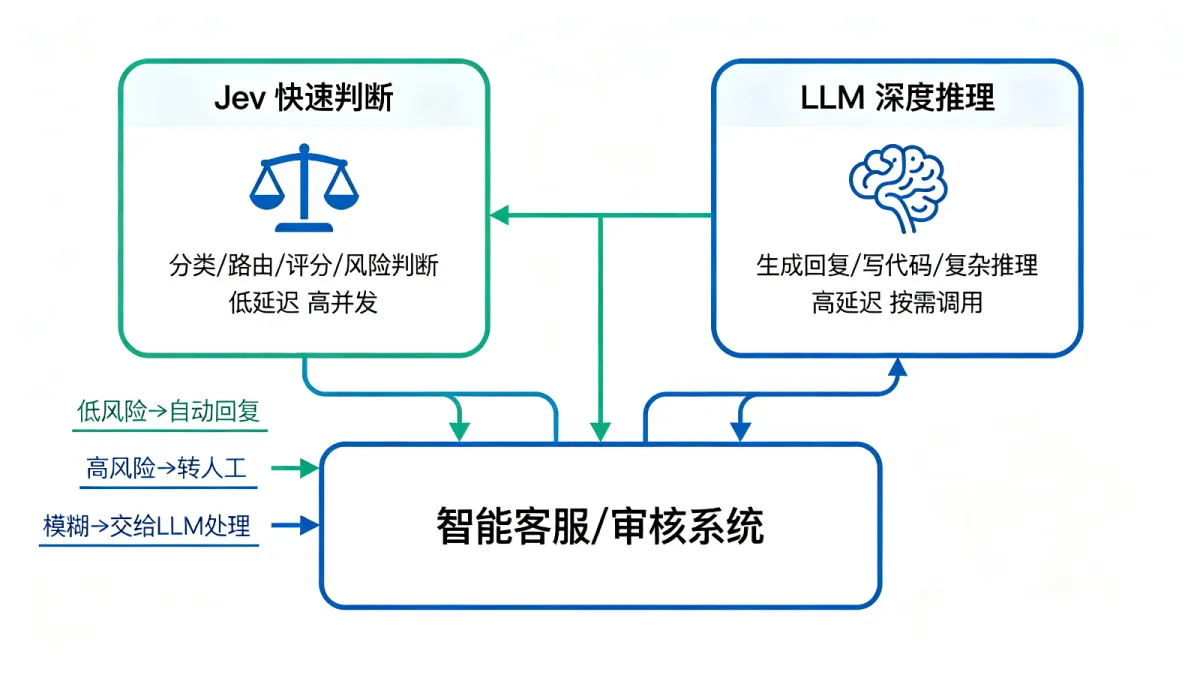
System 1(系统一):快速、直观、自动判断,这正是Jev的强项。
System 2(系统二):缓慢、深思熟虑、复杂推理,LLM负责这部分。
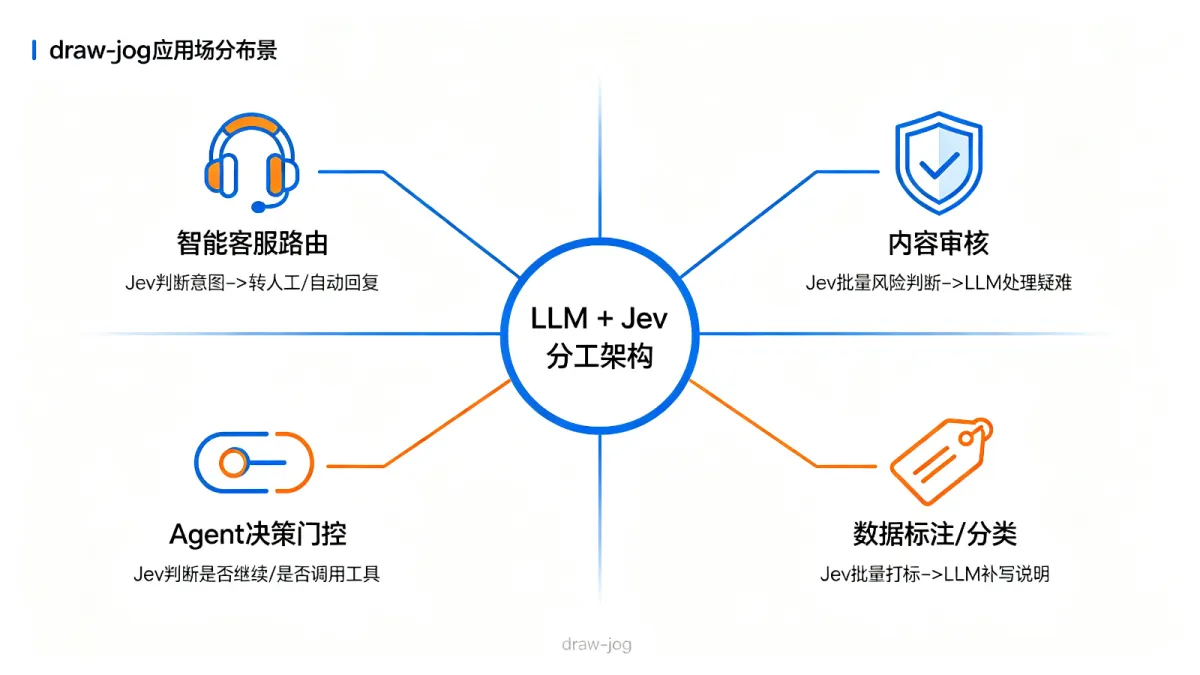
理想的AI系统应该是:Jev处理高频、基础的判断(如路由、分类、评分),只有在Jev不确定或面临复杂任务时,才让LLM介入。这样,80%的请求由廉价快速的Jev处理,20%的复杂请求才由LLM出手,整体成本自然降低了不少。
四、发展历程:从Prompt到System One
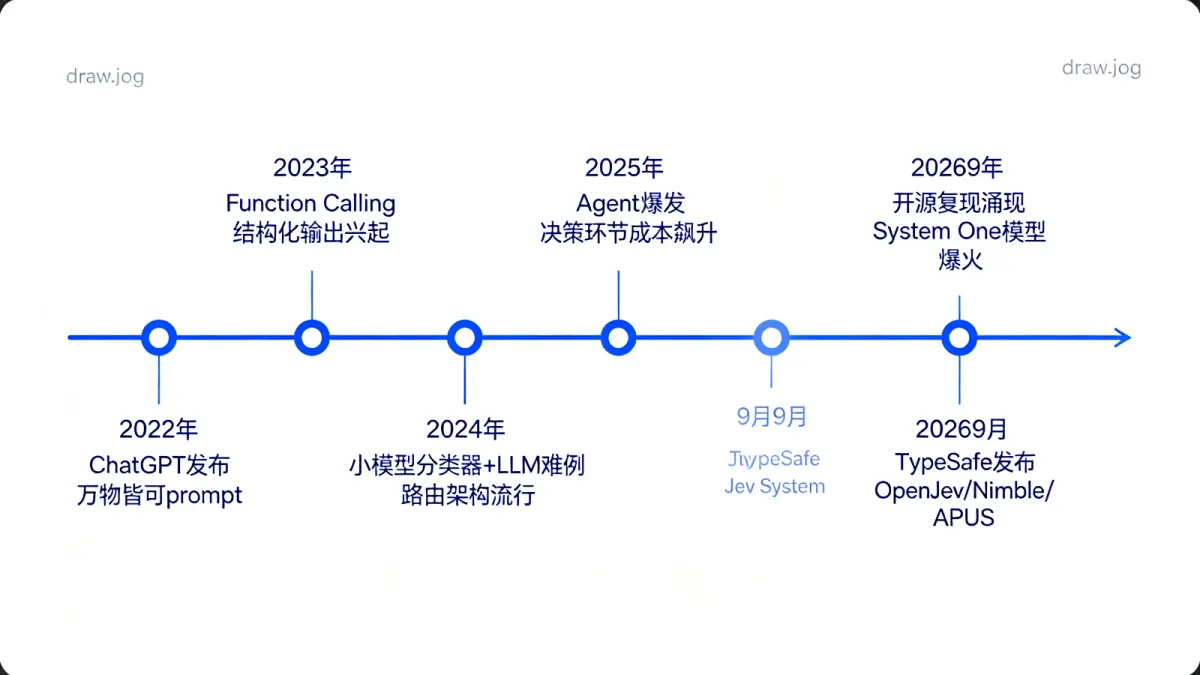
4.1 2022年:万物皆可Prompt
当ChatGPT刚出来时,用户用prompt来处理各种任务,包括分类:“请判断这条评论是正面还是负面,只回答正面或负面。”虽然能用,但速度慢、成本高,格式也不稳定。
4.2 2023年:Function Calling与结构化输出
OpenAI推出Function Calling,各大LLM纷纷跟进,模型可以按预定格式输出JSON。虽然解决了一部分格式问题,但本质上还是自回归生成,速度和成本没有根本变化。
4.3 2024年:小模型路由架构兴起
许多工程团队开始尝试“大小模型路由”,简单问题用小模型(比如DistilBERT),而复杂问题才使用GPT-4。然而因为小模型的理解力有限,路由的准确性得不到保证,而且每个分类任务都需独立训练和部署,维护起来很麻烦。
4.4 2025年:Agent崛起,决策成本飙升
Agent应用激增,一个Agent任务往往要执行多个步骤,每一步都需要决策:“是否调用工具?”“这个结果满意吗?”每一步都要调用LLM,令token费用飙升,延迟也难以接受,行业开始呼唤专门的“决策层”。
4.5 2026年9月:Jev的问世
前OpenAI研究员Diogo Almeida创办的TypeSafe AI推出了Jev,首次将“仅做决策、不生成文本”独立成一类模型。通过新架构、并行采样和校准决策的训练,发布几天内在社交媒体上获得3700万次浏览,14万开发者关注。
4.6 2026年9月中旬:开源复现的热潮
Jev发布后仅4天内,开源社区涌现出多个复现项目:
OpenJev:基于Qwen3.5-4B,通过提取prompt logits实现决策,与Jev一致率达到84.5%。
Nimble:Bespoke Labs推出的开源版本,支持本地部署。
NanoJev / Kev-0.5B:轻量级复现版本。
APUS fast-browser-use:中国APUS公司推出的全球首批跨平台开源复现,支持macOS/Linux/Windows,MIT协议。
4.7 演进逻辑一句话
从“一切都交给LLM处理”,到“让LLM只专注于擅长的事,判断交给专门的快模型”,这是AI工程化从玩具走向生产的必然趋势。
五、如何应用:企业项目的实战代码
说了这么多,接下来我给你几个真实企业场景中的代码示例,涵盖了Jev官方SDK的调用、Cloudflare Workers AI的调用,以及Jev与LLM的混合路由。
5.1 环境准备
# 安装TypeSafe官方Python SDK
pip install typesafe-sdk

# 设置API Key(从https://typesafe.ai申请)
export TYPESAFE_API_KEY="ts-xxxxxxxxxxxx"

# 同时需要一个LLM SDK用于处理复杂任务
pip install openai
5.2 示例1:客服意图分类(Noul + Choice)
这是最常见的用法——用户进线后,首先用Jev判断意图,从而决定将其路由到哪个队列。
from typesafe_sdk import TypesafeClient, Choice, Noul

# 初始化客户端,自动读取TYPESAFE_API_KEY环境变量
client = TypesafeClient()

def classify_ticket(user_message: str):
    """
    用Jev对客服工单进行意图分类和紧急程度判断
    一次调用同时询问两个问题,并行返回
    """
    # 状态:用户的工单内容
    state = {
        "message": user_message,
        "channel": "web_form",
        "user_tier": "premium"
    }

    # 一次调用里同时问两个问题,Jev并行回答
    decisions = client.ask(
        state=state,
        questions=[
            # 问题1:Choice —— 意图分类
            Choice(
                question="用户的主要意图是什么?",
                options=[
                    "refund",          # 退款
                    "technical_issue", # 技术问题
                    "billing",        # 账单问题
                    "general_inquiry"  # 一般咨询
                ]
            ),
            # 问题2:Noul —— 是否紧急
            Noul(
                question="这条工单是否需要在1小时内人工处理?"
            )
        ]
    )

    # 解析结果,直接获得类型化数据,不需要解析JSON
    intent = decisions[0].selected  # "refund" / "technical_issue" ...
    intent_probs = decisions[0].probabilities  # 每个选项的概率分布

    is_urgent = decisions[1].answer  # True / False
    urgency_prob = decisions[1].probability  # 0.0 ~ 1.0

    return {
        "intent": intent,
        "intent_confidence": intent_probs[intent],
        "is_urgent": is_urgent,
        "urgency_probability": urgency_prob
    }

# 测试
result = classify_ticket(
    "我付了钱但APP一直闪退,数据全没了,必须马上解决!"
)
print(result)
# 输出示例:
# { 'intent': 'technical_issue', 'intent_confidence': 0.85, 'is_urgent': True, 'urgency_probability': 0.9 }