 优推编辑部
最近,AI领域正因为一个名叫Jev的模型而热闹非凡。这款由TypeSafe AI推出的“系统一模型”,打破了以往对大型模型的固有认知。它证明了在高频、低延迟的意图理解任务中,专用模型同样能做到迅速而准确。于是,决策层与生成层的分离,一下子成了AI Agent落地的热门话题。
不过,Jev也留给我们一个悬而未决的问题:用户一旦表明了意图,谁来为具体的指令负责?
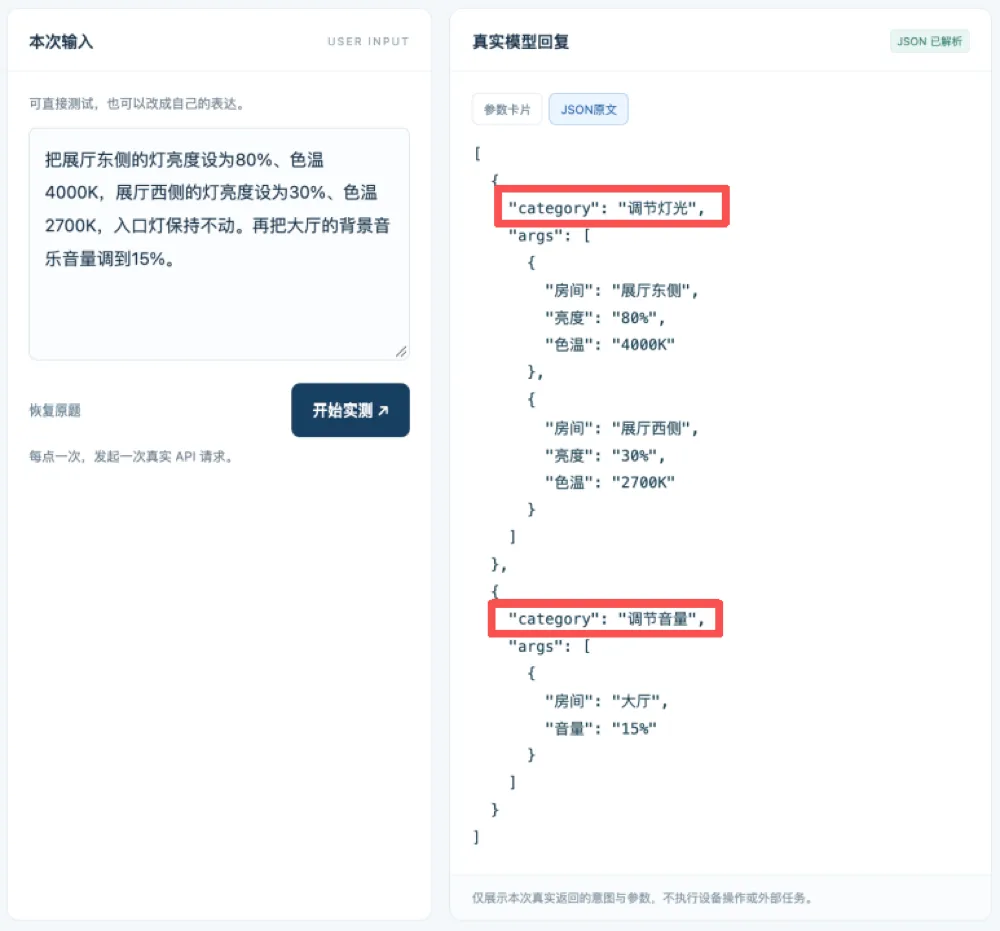
比如,当用户说“把展厅东侧的灯调到80%、色温4000K,西侧调到30%、2700K,入口灯别动”时,系统识别出“调节灯光”只是第一步。接下来,它还得明确每盏灯的具体亮度和色温,以及哪盏灯需要保持原样。
在真实的AI Agent场景中,这类指令并不少见。正确的判断只是基础,而要将用户的自然语言精确转化为结构化参数,并区分哪些是需要执行的操作,哪些是要保持不变,才是真正的挑战。
不过,10月19日中电信人工智能科技有限公司的星辰通用人工智能实验室推出了Xing4.0-29B-Intent,试图填补这个能力的空白。它将意图理解扩展为“选择题+填空题”,并把模型、训练数据和推理SDK一并开源。
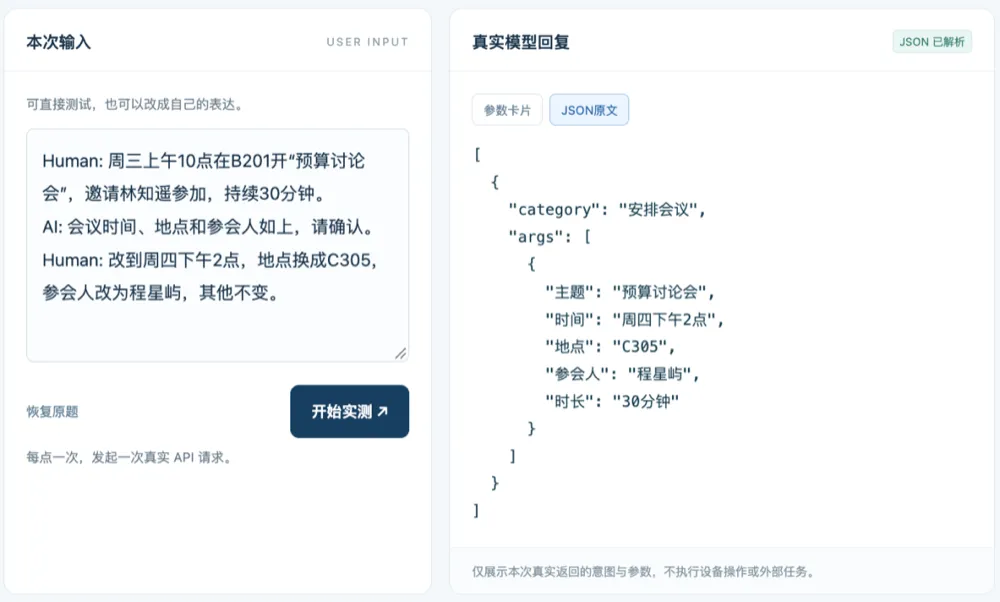
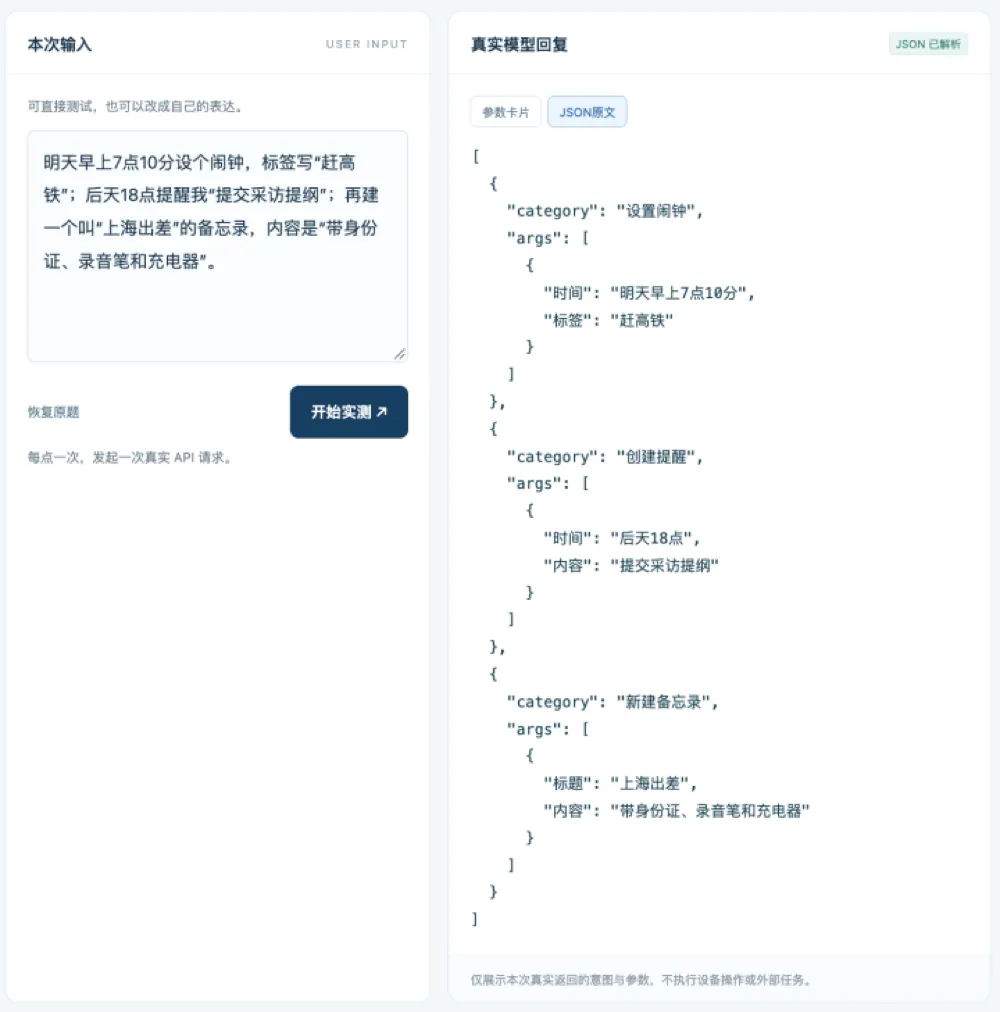
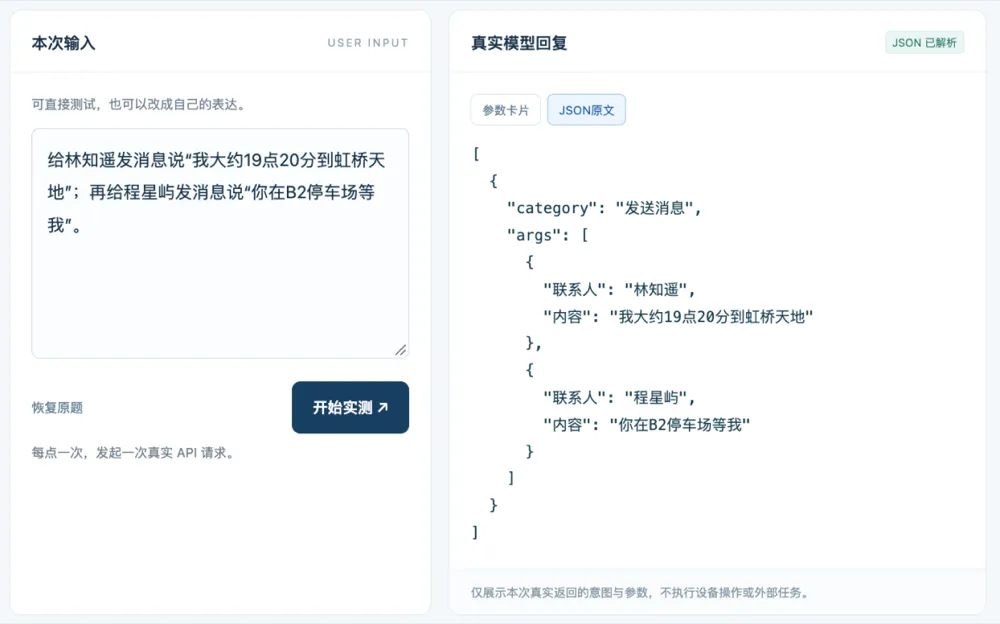
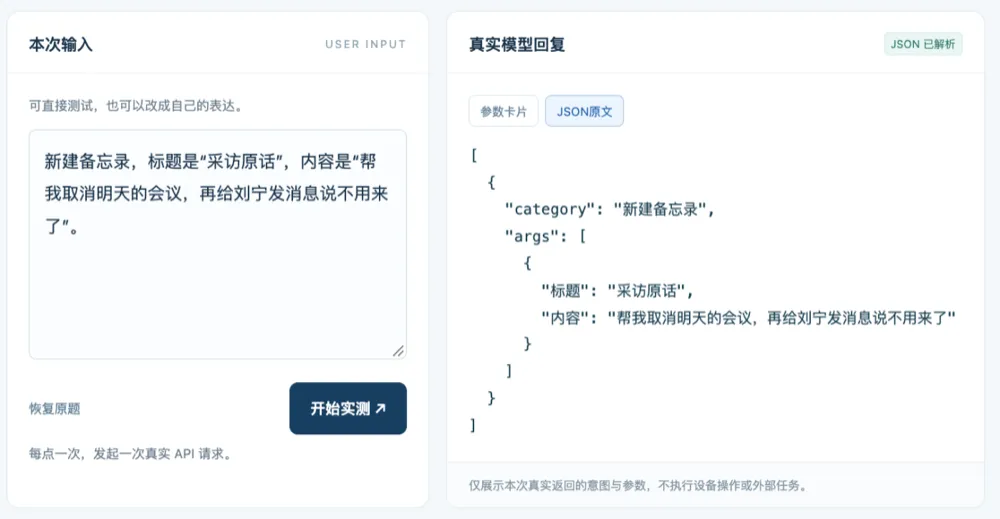
我个人体验了一下它的接口,围绕智能空间、智能座舱、办公协同和个人助手等场景进行了11组实测,想看看它在更复杂指令下,意图识别与参数提取的表现如何。
一、Jev与Xing的比较:选择题VS选择加填空
意图理解正在成为AI Agent落地中至关重要的一环。过去我们关注的是大模型是否能听懂一句话,但如今,真正接入手机、汽车和企业软件时,单纯的意图判断显然不够。
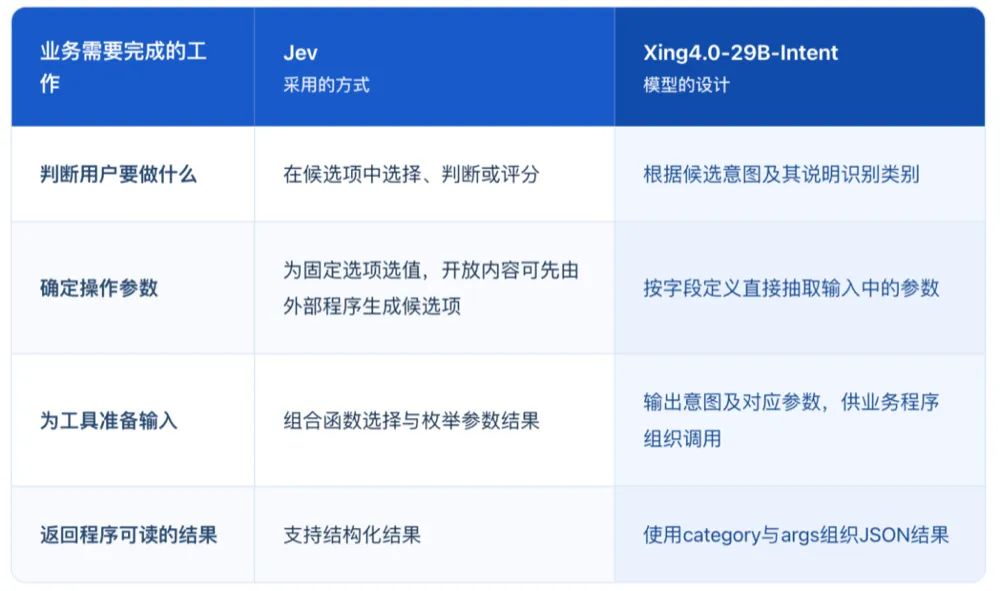
先看看Jev的功能。它提供三种决策原语:Noul布尔判断、Choice分类选择和Score标尺打分。Noul以“是/否”形式回应,并返回一个概率值;Choice则从一组选项中挑出最匹配的;Score则在有序量表上给出分数。
这三种原语可以同时进行,延迟低到70毫秒,适合快速完成预定义判断。但问题是,这些输出仍受到候选选项的限制,无法直接满足真实业务中的复杂参数提取需求。
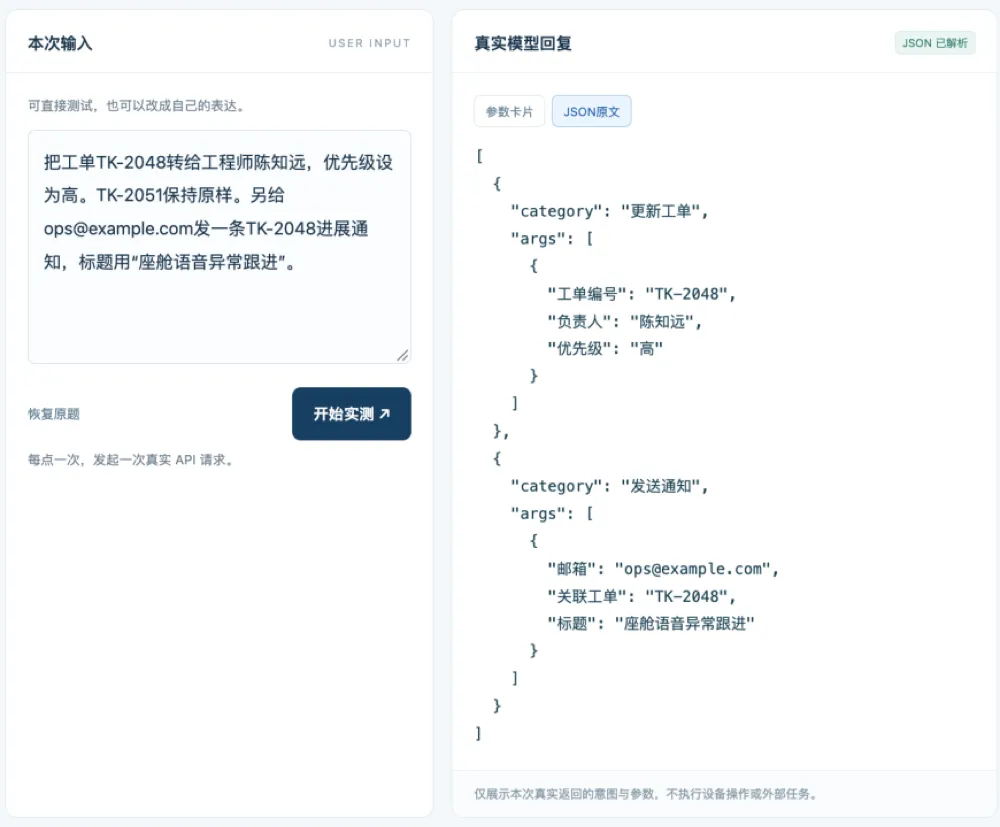
例如,“把卧室的灯调到30%,客厅调到70%”,模型需要找出卧室和客厅两个对象,并将30%和70%对应清楚。如果再换成“把工单TK-2048转给陈知远,优先级设为高,TK-2051保持原样”,那么模型还得理解两个工单有不同的处理要求。
这些任务涉及意图分类、信息抽取、实体关联和上下文理解。用户语言越自然,背后的参数往往就越复杂。
Xing4.0-29B-Intent则将意图分类与参数抽取整合到一个模型中。它不仅能判断输入对应的意图,还能提取实体、数值和相关属性,统一通过JSON结构返回。
举个例子,在展厅灯光测试中,用户要求将东侧的灯调到80%、色温4000K,西侧调到30%、2700K,入口灯保持不动,同时把大厅的音量调到15%。模型一次性返回了两类意图,准确对应了每个参数,避免了用户要求保持不变的设备被误操作的情况。
这种能力在智能家居中十分常见,但是当多个对象、不同数值和否定要求同时出现,模型就需要更细致的语义理解能力。
对AI Agent来说,判断意图决定了任务的方向,而参数抽取则关系到后续操作是否能够准确回应用户要求。这也是Xing4.0-29B-Intent与Jev之间值得注意的能力差异。
至于性能,Xing4.0-29B-Intent的速度也没有因为“填空”而变慢。它的端到端推理延迟低于150毫秒,完美落在Jev的70到500毫秒的范围内。而结构化JSON输出则带有强约束,Xing4.0-29B-Intent的格式幻觉也被压低到极致。
二、零样本冷启动,硬数据拉开差距
在能力定位之外,成绩也很重要。意图理解的应用长期面临一个成本问题:每接入一个新业务场景,往往需要重新整理意图类别、标注数据,甚至重新训练模型。
如果模型可以在没有示例的情况下识别新类别和抽取参数,开发者在接入业务系统时的工作量将大幅降低。
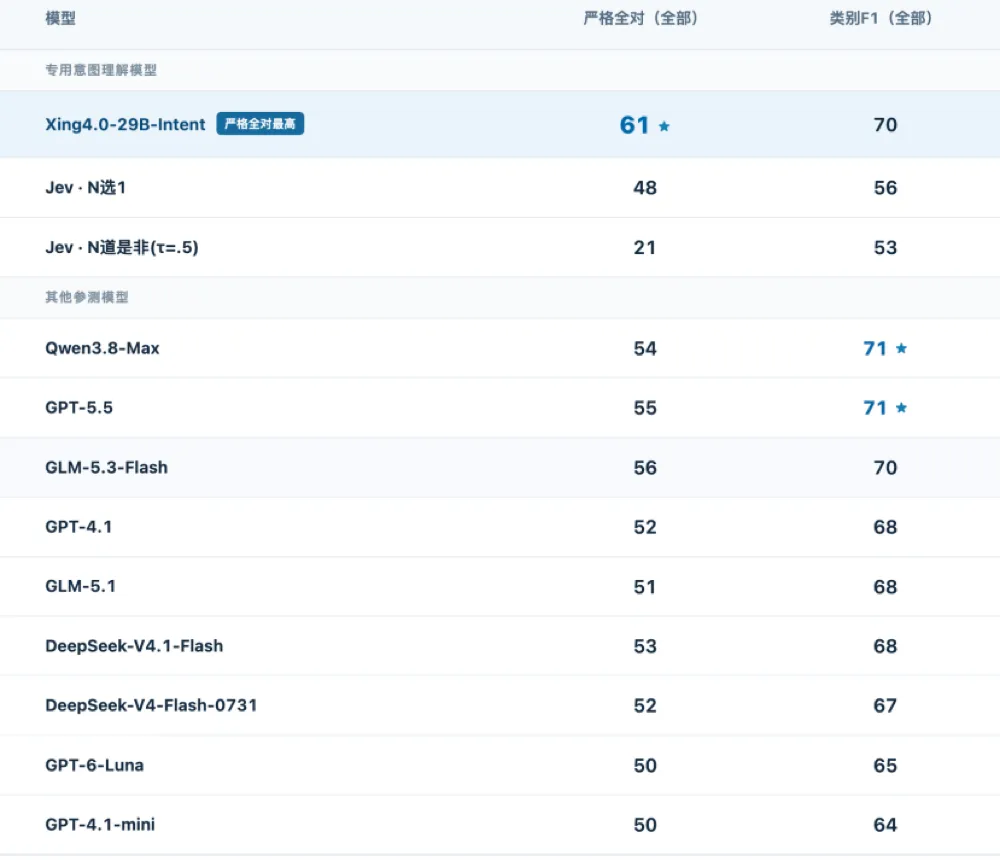
这就是零样本能力的重要性。在零样本冷启动评测中,Xing4.0-29B-Intent的Micro-F1达到了70.27,超出Jev最优配置12.62个百分点,甚至超过了GPT-4.1。这一指标反映了模型在识别意图和提取信息方面的综合表现。
在要求结果全部正确的严格评测上,Xing4.0-29B-Intent取得了61的成绩,而Jev在不同配置下仅在21到48之间。
看得出,这两类模型在任务设计上的关注点有所不同。Jev主要优化预定义选项中的快速决策;而Xing4.0-29B-Intent则致力于处理输入文本中的实体、属性和参数,后者的输出要求更加复杂,更贴近需要结构化信息的业务场景。
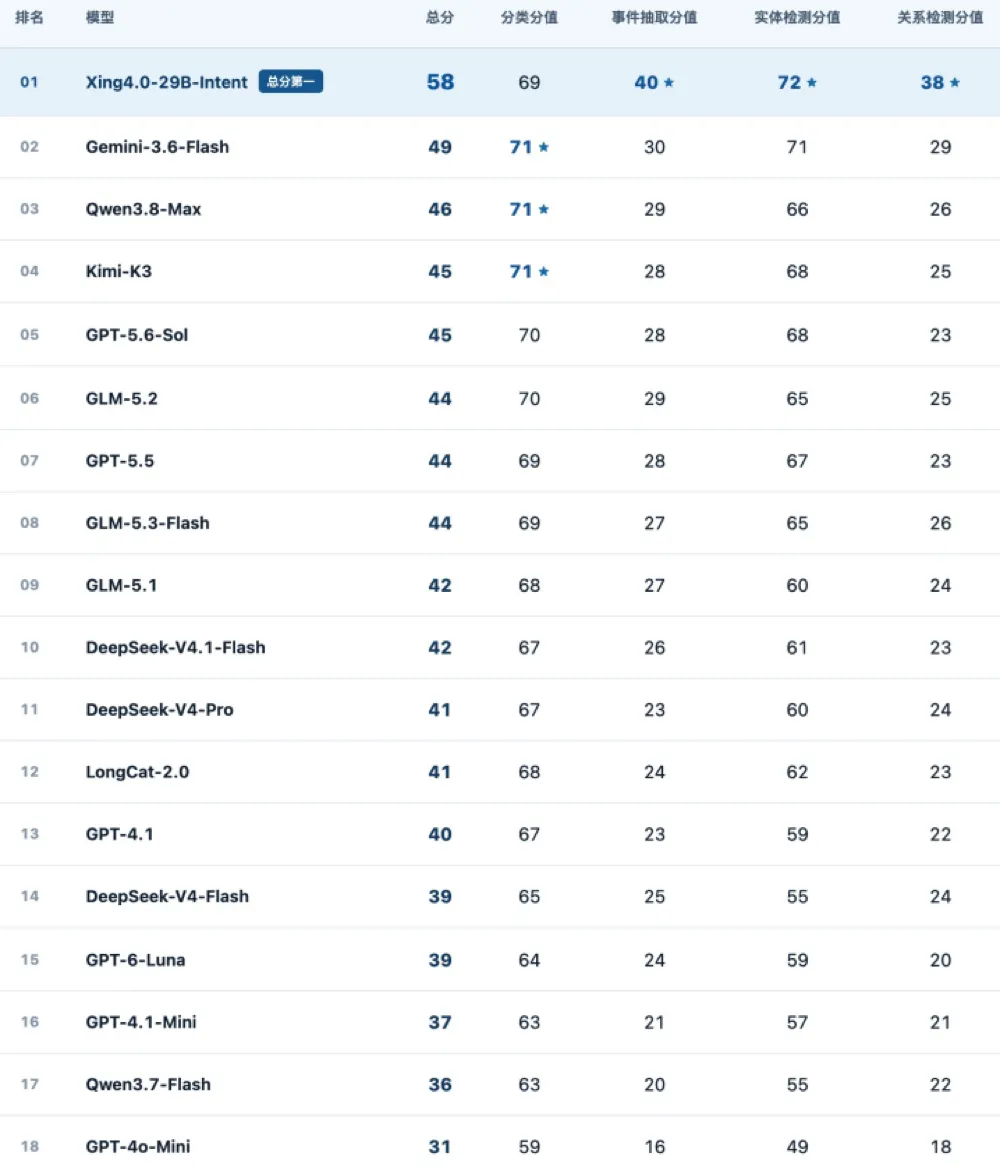
再看统一评测。Xing4.0-29B-Intent在覆盖48个公开数据集的评测中,总分达到了58,比第二名Gemini-3.6-Flash高出了9分,且在实体识别、关系抽取、事件抽取和意图理解等任务中都取得了领先的成绩。
其中,实体检测需要找准文本中的人名、地名和组织名称;关系检测则关注不同实体之间的联系;事件抽取则涉及事件类型及其参与要素。这些看似不同的任务,都与结构化信息的准确性息息相关。
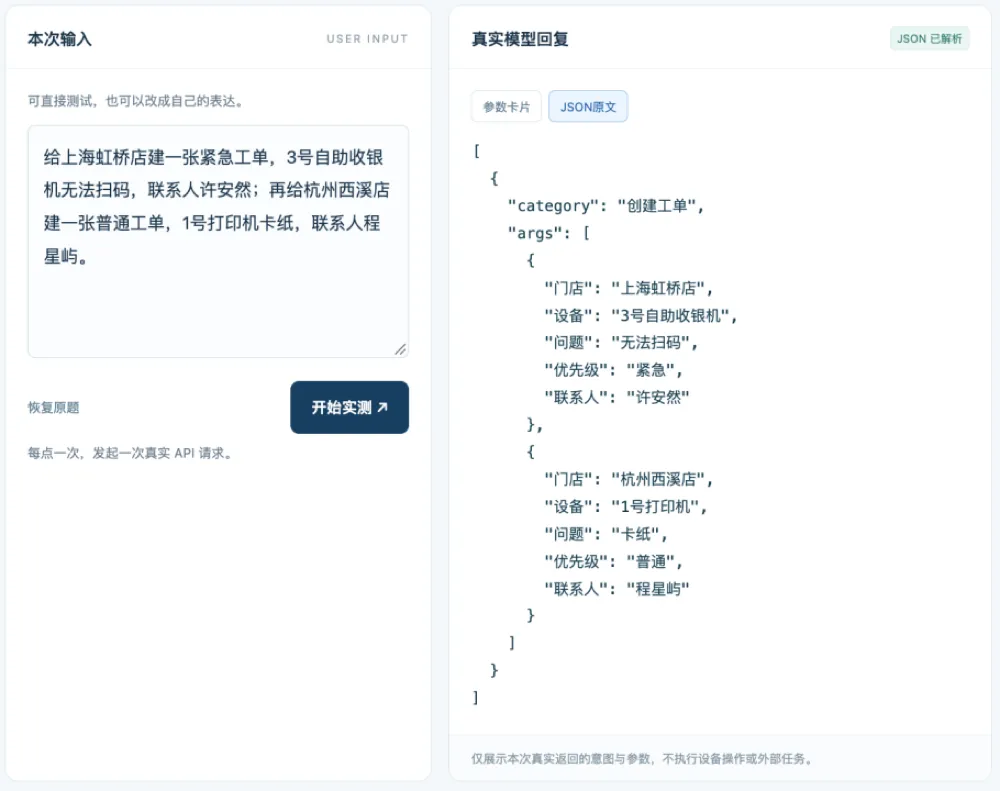
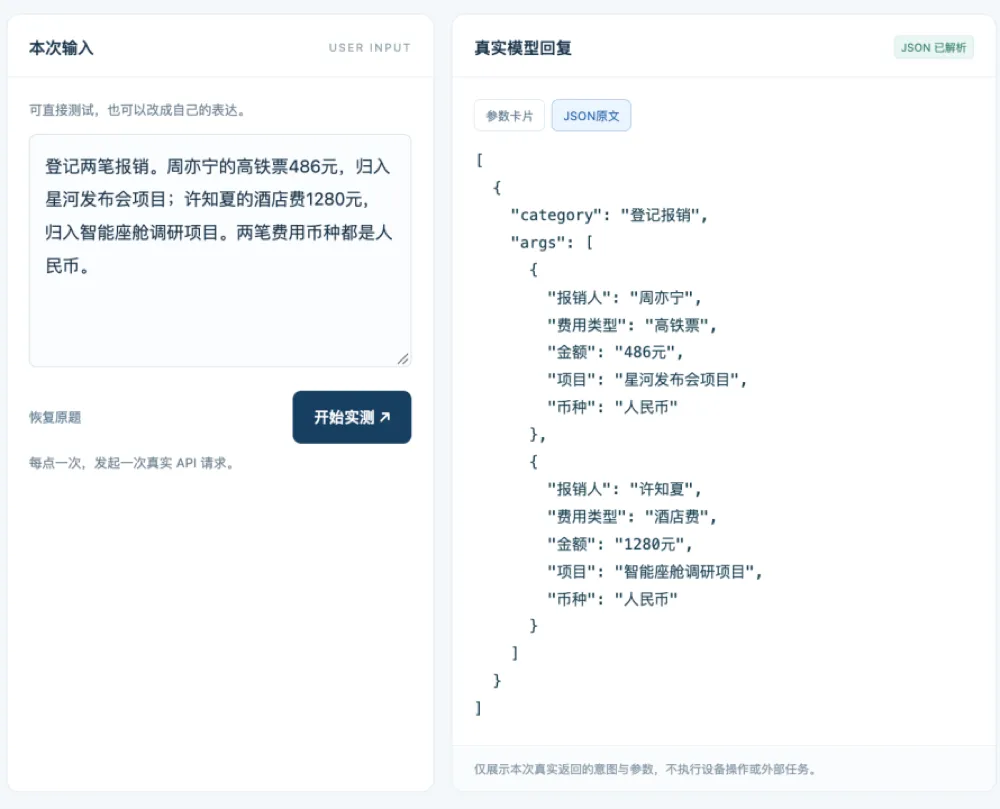
比如,用户要求“登记两笔报销”,模型需要找出报销人、费用类型、金额和所属项目;用户要求“创建两张工单”,模型则需准确关联门店、设备、故障与联系人。
意图分类只能回答这些任务属于哪个类别,而更完整的语义解析则需要将每条信息放到正确的位置上。
可以说,Jev验证了专用模型能承担高频判断任务,而Xing4.0-29B-Intent则为专用模型承担结构化信息整理提供了全新思路。这对希望降低业务适配成本的开发者来说,具有重要的意义。
三、11组真实场景实测,智能座舱与个人助手都能派上用场
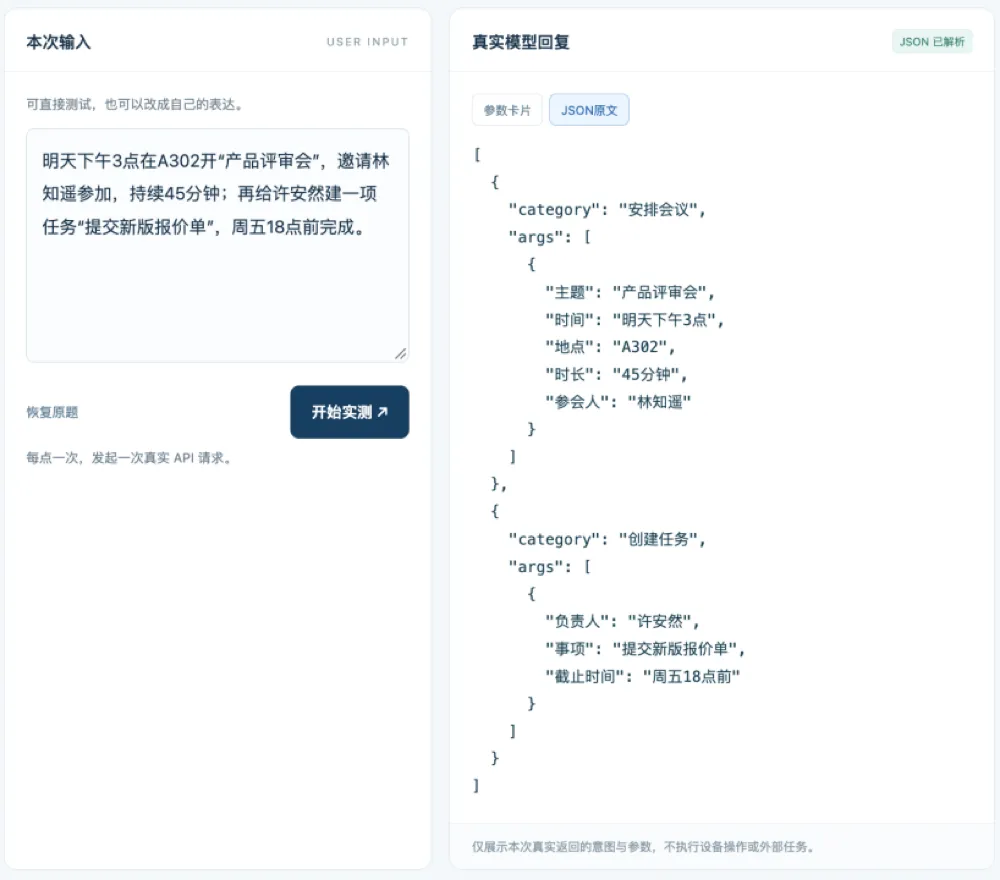
除了统一评测,我们更关注模型在实际场景中的表现。这次智东西进行了11组测试,覆盖智能空间、智能座舱、企业业务、办公协作及个人助手等场景,进一步考验复杂指令理解与参数抽取能力。
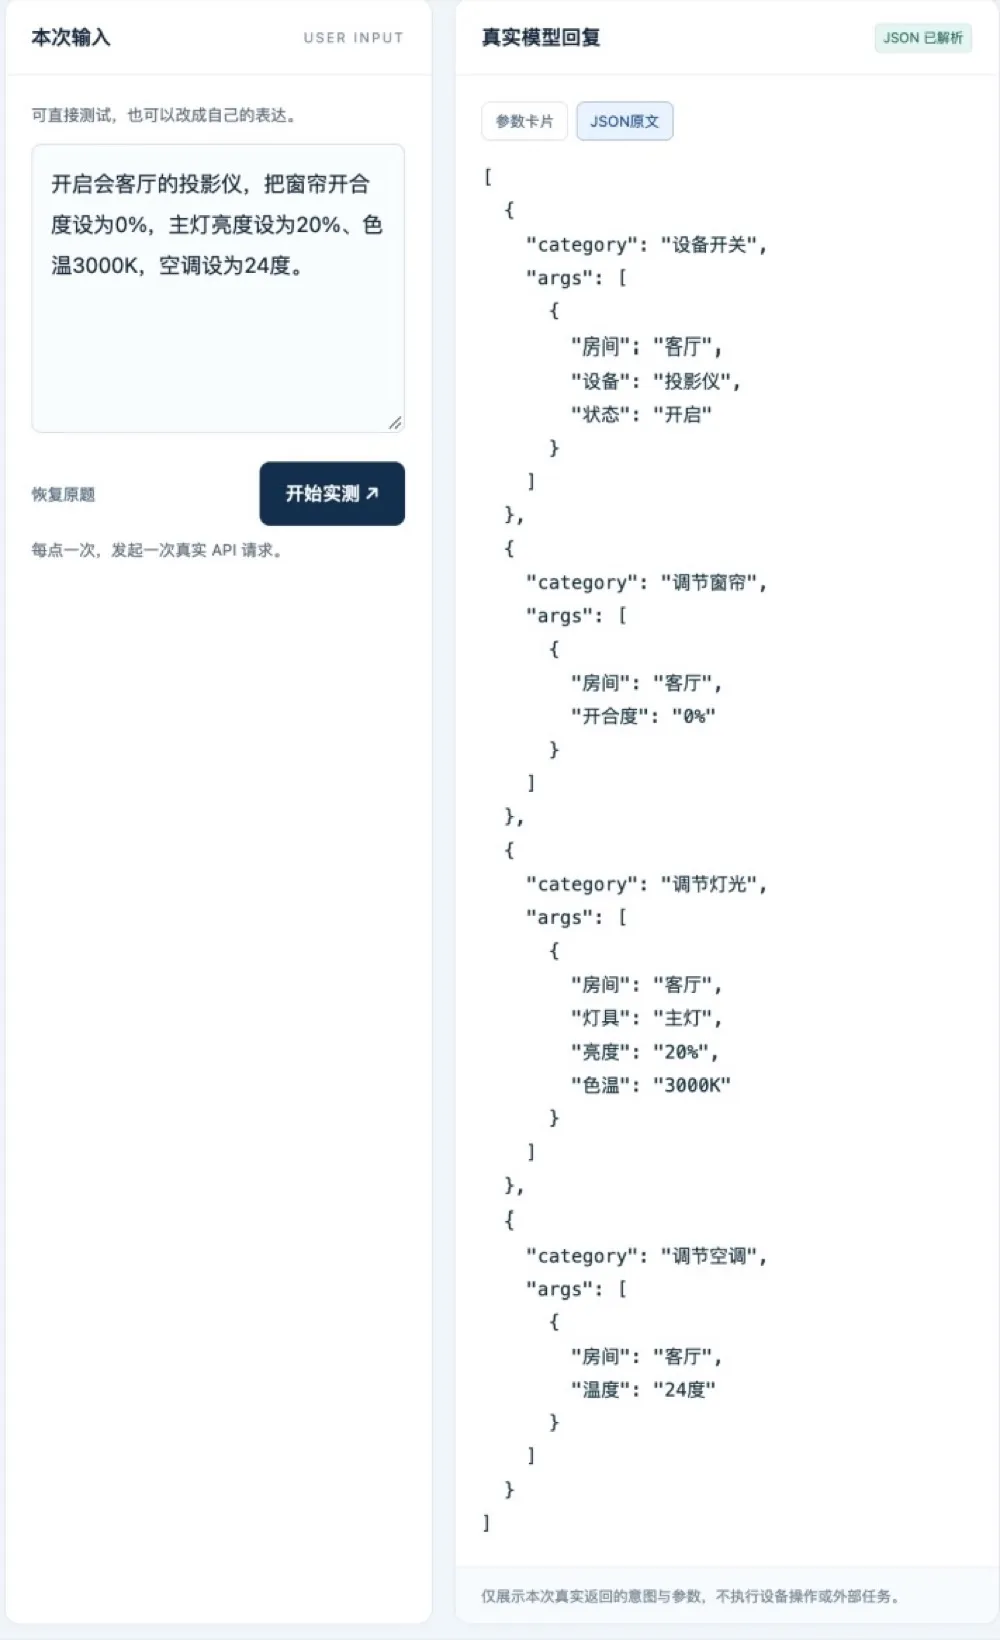
在智能空间的测试中,模型一次性识别了投影仪、窗帘、主灯和空调等四类意图,准确对应了不同区域与各类设备的控制。
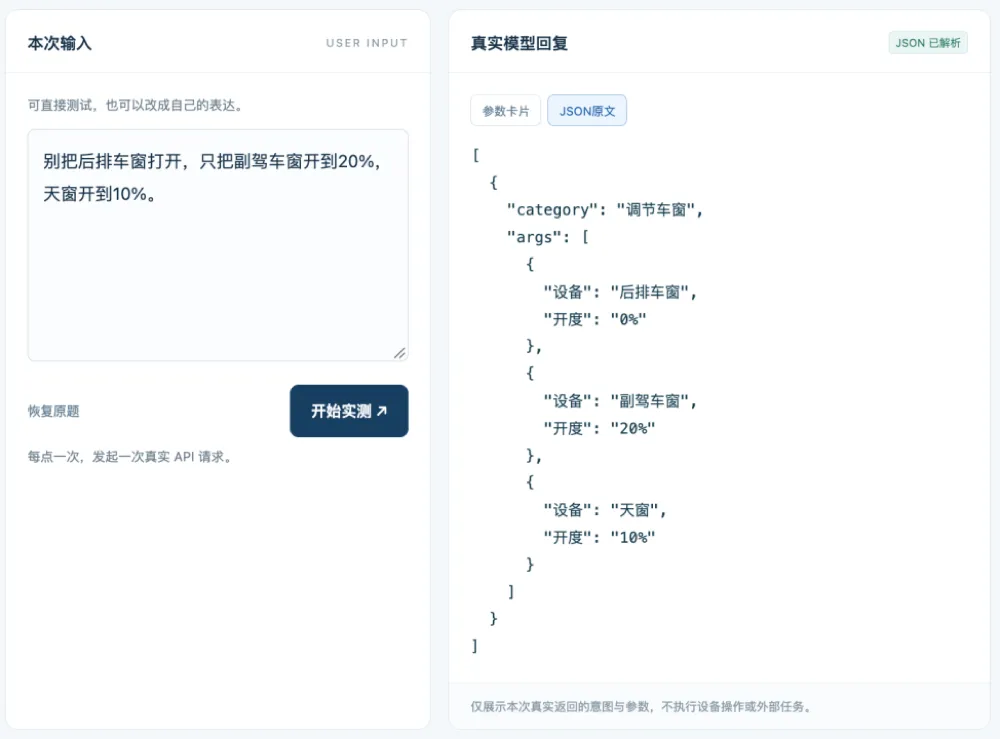
而在智能座舱的测试中,它面对多个车窗的控制要求,成功提取了副驾车窗和天窗的开度。
不过,这里有个小偏差需要注意。如果后排车窗原本开着,执行0%的参数反而会导致其状态改变。因此,在涉及物理设备的场景中,准确理解否定指令的重要性不容忽视。
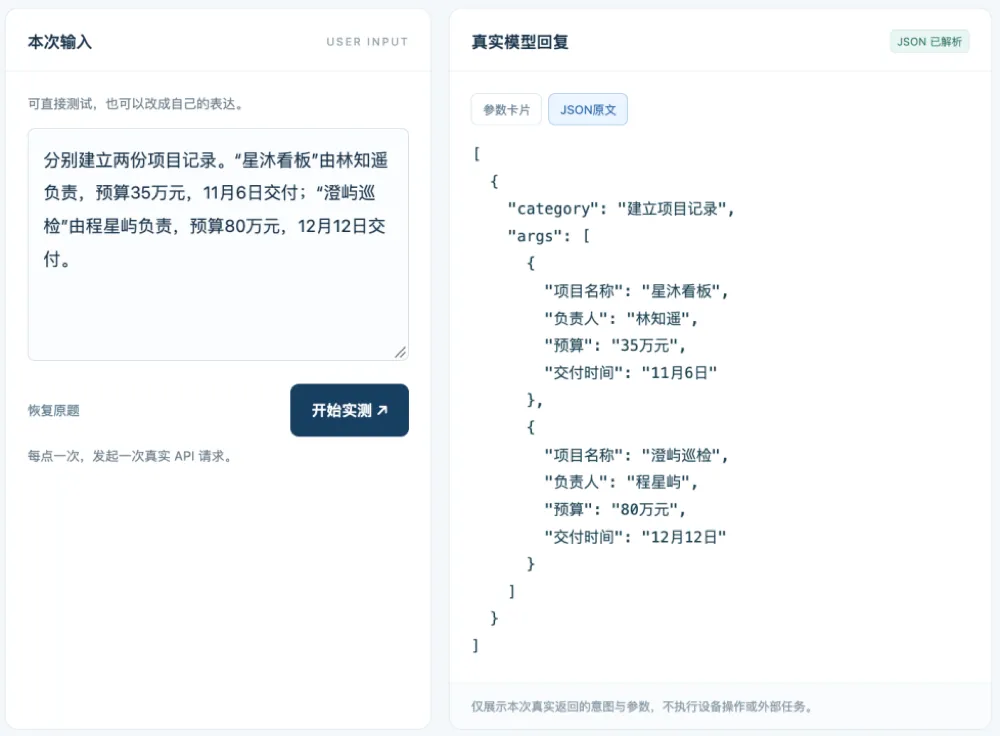
在企业业务中,情况更加复杂:信息量大、字段多,必须明确。我们测试了工单创建、工单更新、项目管理和费用报销。模型能够清晰区分不同门店、设备故障和联系人,并且在项目记录中也能准确识别负责人、预算和交付时间。当处理两笔不同人员的报销时,它还能准确关联费用类型、金额、币种和所属项目。
这些看似繁琐的字段,实际上却是企业系统运作的核心。只有将这些信息准确提取,才能确保后续的业务流程畅通无阻。
总结下来,Jev的引领之路为我们展示了专用模型的潜力,而Xing4.0-29B-Intent则以其实用的结构化能力,进一步推动了这一领域的发展。这对于希望在智能视频应用中降低成本的开发者来说,无疑是一种新的选择和启示。